10만 건 우주 미션 데이터, React DataGrid로 단번에 탐험하기! (AG Grid 대안?)
2026. 8. 25.
10만 건 우주 미션 데이터, React DataGrid로 단번에 탐험하기! (AG Grid 대안?)
이전 글에서 React DataGrid: 엔터프라이즈 에디션까지 갖춘 무료 오픈소스 리액트 데이터 그리드 (AG Grid의 대안)를 통해 React DataGrid의 기능들을 자세히 살펴봤었죠. 문서와 기능 목록만으로는 알 수 없는 실제 사용 경험을 얻고 싶었습니다.
그래서 실제 프로젝트에서 여느 데이터 그리드를 다루듯이 React DataGrid를 사용해 보기로 했습니다. 실제 데이터셋으로 시작해서 유용한 인터랙션을 구축하고, 대량의 레코드로 그리드를 한계까지 밀어붙여 보면서 어떤 부분에서 어려움이 생기는지 직접 확인해보고 싶었거든요.
그 결과물로 **우주 미션 및 위성 탐사기(Space Mission & Satellite Explorer)**를 만들었습니다. 여러 기관, 목적지, 미션 유형, 그리고 시대별 미션들을 탐색할 수 있는 작은 비행 역학 스타일의 웹 애플리케이션이죠.
이 프로젝트는 10만 건의 미션 라이브 아카이브와 연동되는데, 이 중 1,200개의 행으로 구성된 클라이언트 측 작업 세트가 인터랙티브한 분석 경험을 제공합니다. 덕분에 기본적인 정렬이나 페이지네이션을 넘어 필터링, 패싯 검색, 그룹화, 피벗팅, 행 고정, 커스텀 셀 렌더러, 가상 스크롤, 서버 사이드 무한 스크롤 등 훨씬 많은 기능을 테스트할 기회를 얻었습니다.
또한, 같은 데이터를 기반으로 두 가지 애플리케이션 파트를 추가로 구축했습니다. 데이터셋을 집계하고 시각화하는 미션 분석(Mission Analytics) 페이지, 그리고 개별 미션의 타임라인을 트리 데이터로 표현한 미션 상세(Mission Details) 페이지입니다.
이번 글은 이 탐사기를 만들면서 React DataGrid를 설정하고 첫 컬럼을 구성하는 과정부터 10만 개 레코드를 다루는 경험, 그리고 데이터가 많은 다른 React 프로젝트에서 이 라이브러리를 다시 사용할 것인지에 대한 고민까지, 그 모든 여정을 담고 있습니다.
핵심 요약 (TL;DR)
저는 React DataGrid가 실제 애플리케이션에서 어떻게 동작하는지 확인하기 위해 우주 미션 탐사기를 만들었습니다.
이 프로젝트는 인터랙티브 분석을 위해 1,200개 행의 클라이언트 측 데이터셋을 사용하며, 서버 사이드 무한 스크롤을 통해 로드되는 10만 개 행의 라이브 아카이브를 활용합니다.
개발 과정에서 다음과 같은 기능들을 사용했죠:
- 다중 컬럼 정렬 (multi-column sorting)
- 빠른 검색 (quick search)
- 패싯 필터링 (faceted filtering)
- 행 그룹화 (row grouping)
- 행 고정 (row pinning)
- 피벗 테이블 빌더 (Pivot Table builder)
- 커스텀 셀 렌더러 (custom cell renderers)
- 가상 스크롤 (virtual scrolling)
- CSV/Excel 내보내기 (CSV/Excel export)
- 미션 타임라인을 위한 트리 데이터 (Tree Data)
통합 과정은 예상보다 훨씬 매끄러웠습니다. 처음 API를 접했을 때부터 익숙한 느낌이었고, 필요한 대부분의 기능들이 문서화된 예제에서 크게 벗어나지 않고 예상대로 작동했습니다. 작은 작업 데이터셋과 전체 아카이브 사이를 전환할 때도 반응성이 좋았죠.
물론, 좀 더 깊이 파고들어야 했던 몇몇 부분도 있었는데, 이는 나중에 다시 다룰 예정입니다. 하지만 전반적으로 이 프로젝트를 구축하면서 React DataGrid에 대한 인상은 단순히 기능 목록을 읽었을 때보다 훨씬 좋았습니다. 제가 실무에서 대용량 데이터를 다뤄봤을 때, 이런 라이브러리의 익숙하고 직관적인 API는 개발 초기 단계의 생산성을 크게 좌우한다는 점이 정말 중요하게 다가왔어요.
구축한 것: 우주 미션 탐사기
저는 이 프로젝트를 **오비탈 인덱스 / 미션 데이터 터미널(Orbital Index / Mission Data Terminal)**이라고 이름 붙였습니다.
아이디어는 간단했습니다. 방대한 양의 가상의 우주 미션 기록 아카이브를 가져와서, 개발자들이 실제로 사용할 만한 검색 및 필터링 가능한 인터페이스로 만드는 것이었죠. 이 인터페이스를 통해 기관, 목적지, 상태, 미션 유형, 발사일, 기간, 비용, 그리고 연대별로 미션들을 탐색할 수 있습니다.
저는 의도적으로 일반적인 CRUD 대시보드를 만드는 대신 이 프로젝트를 선택했습니다. 데이터셋 자체가 데이터 그리드가 유용해지는 문제 유형을 자연스럽게 만들어냈기 때문이죠.
미션 기록에는 필터링과 정렬을 의미 있게 만들 수 있는 충분한 구조화된 필드가 있습니다. 미션은 기관이나 목적지별로 그룹화될 수 있고, 비용과 기간은 집계될 수 있죠. 그리고 미션 자체는 다음과 같은 자연스러운 계층 구조를 가집니다:
발사 → 지구 궤도 진입 → 달 전이 궤도 진입 → 달 궤도 진입 → 하강 및 착륙 → 표면 작전 → 지구 귀환
이 마지막 부분은 단순히 기능 목록을 채우기 위해서가 아니라, Tree Data를 실제로 테스트해야 할 합당한 이유를 제공했습니다.
애플리케이션은 결국 세 가지 주요 페이지로 구성되었습니다:
- 미션 탐사기 (Mission Explorer): 미션 아카이브를 검색, 필터링, 그룹화, 피벗팅, 편집, 탐색하는 메인 데이터 그리드 인터페이스입니다.
- 미션 분석 (Mission Analytics): 동일한 미션 데이터를 성공률, 기관 비교, 목적지 분포, 기간 통계, 비용 분석 등의 시각화로 변환하는 차트 중심의 뷰입니다.
- 미션 상세 (Mission Details): 메타데이터, 승무원 및 장비 정보, 관련 문서, 그리고 계층적 미션 타임라인을 포함하는 개별 미션 뷰입니다.
탐사기(Explorer) 페이지는 React DataGrid 테스트의 대부분이 이루어진 곳입니다. 분석(Analytics) 페이지는 동일한 1,200개 행의 작업 데이터셋과 집계 로직을 사용하여 시각화를 생성했고, 상세(Details) 페이지는 그리드의 계층적 데이터 기능을 완전히 다른 사용 사례로 활용할 기회를 제공했습니다.
기술 스택으로는 React, TypeScript, Tailwind CSS, React DataGrid, 미션 데이터셋, 그리고 분석 뷰를 위한 차트 라이브러리를 사용했습니다.
그리드에 대한 내용을 본격적으로 다루기 전에 한 가지 투명성 고지: 이 실험의 핵심이 아닌 보일러플레이트 구축에 많은 시간을 낭비하는 것을 피하기 위해 초기 프로젝트 설정의 작은 부분은 vibe-coding을 했습니다.
여기서 목표는 처음부터 전체 우주 미션 웹사이트를 구축할 수 있음을 증명하는 것이 아니었습니다. 실제 프로젝트에서 React DataGrid를 사용하며 데이터, 상호작용, 규모를 어떻게 다루는지 시간을 할애하여 확인하는 것이었죠.
저는 프로젝트를 처음부터 끝까지 이해할 수 있을 만큼 작게 유지하면서도, 기본적인 <table>이 문제가 되기 시작할 만큼은 복잡하게 만들었습니다.
전체 프로젝트를 확인하고 직접 미션들을 탐색해 보세요.
{% cta https://orbitalindex.vercel.app/ %} 라이브 데모 👀 {% endcta %}
{% cta https://github.com/Hadil-Ben-Abdallah/space-mission-explorer %} 깃허브 저장소 ⭐ {% endcta %}
React DataGrid 설정하기
프로젝트 구조를 잡은 후, 다른 인터페이스 작업에 시간을 투자하기 전에 그리드를 먼저 작동시키고 싶었습니다. 오픈소스 패키지로 시작했고, 첫 렌더링은 의도적으로 간단하게 유지했죠.
설치는 매우 간단했습니다:
npm install react-open-source-grid
그리고 라이브러리의 스타일시트를 임포트했습니다:
import 'react-open-source-grid/dist/lib/index.css';
첫 테스트를 위해 몇 개의 미션 필드만 포함하는 작은 그리드를 만들었습니다:
const columns: Column[] = [
  { field: 'mission', headerName: 'Mission', width: 200 },
  { field: 'agency', headerName: 'Agency', width: 120 },
  { field: 'status', headerName: 'Status', width: 140 },
  { field: 'launchDate', headerName: 'Launch Date', width: 130 },
  { field: 'destination', headerName: 'Destination', width: 150 },
];
여기서부터 미션(Mission), 기관(Agency), 상태(Status), 발사일(Launch Date), 목적지(Destination), 미션 유형(Mission Type), **기간(Duration)**에 대한 타입이 지정된 컬럼들을 정의하고 데이터셋을 이 컬럼들에 매핑했습니다.
이 단계에서 API가 매우 익숙하게 느껴져서, 완전히 새로운 그리드 모델을 배우는 데 많은 시간을 할애할 필요가 없었습니다. 제가 실무에서 다양한 데이터 그리드 라이브러리를 사용해 봤을 때, 초기 설정의 직관성은 개발 초기 속도에 결정적인 영향을 미친다고 생각해요.
또한, 실전 테스트인 만큼 React DataGrid의 GitHub 저장소와 문서를 항상 가까이에 두고 작업했습니다.
미션 탐사기 구축하기
저는 단순히 몇 개의 행으로 이루어진 그리드를 만들어서 "사용해봤다"고 말하고 싶지 않았습니다. 실제 애플리케이션에서 예상되는 복잡성을 컴포넌트가 다룰 수 있는지 확인하기 위해 충분한 데이터와 충분한 상호작용이 필요했죠.
결과적으로 두 가지 데이터셋 모드를 사용했습니다. 인터랙티브 분석, 가상 스크롤을 위한 1,200개 행의 클라이언트 측 작업 세트와, 서버 측 무한 스크롤을 통해 요청 시 레코드를 로드하는 10만 개 행의 라이브 아카이브입니다.
두 모드 간의 차이는 유용했습니다. 단순히 벤치마킹을 위해 인위적으로 거대한 데이터셋을 만드는 대신, 동일한 미션 데이터를 다루는 두 가지 다른 방법을 제공했기 때문이죠.
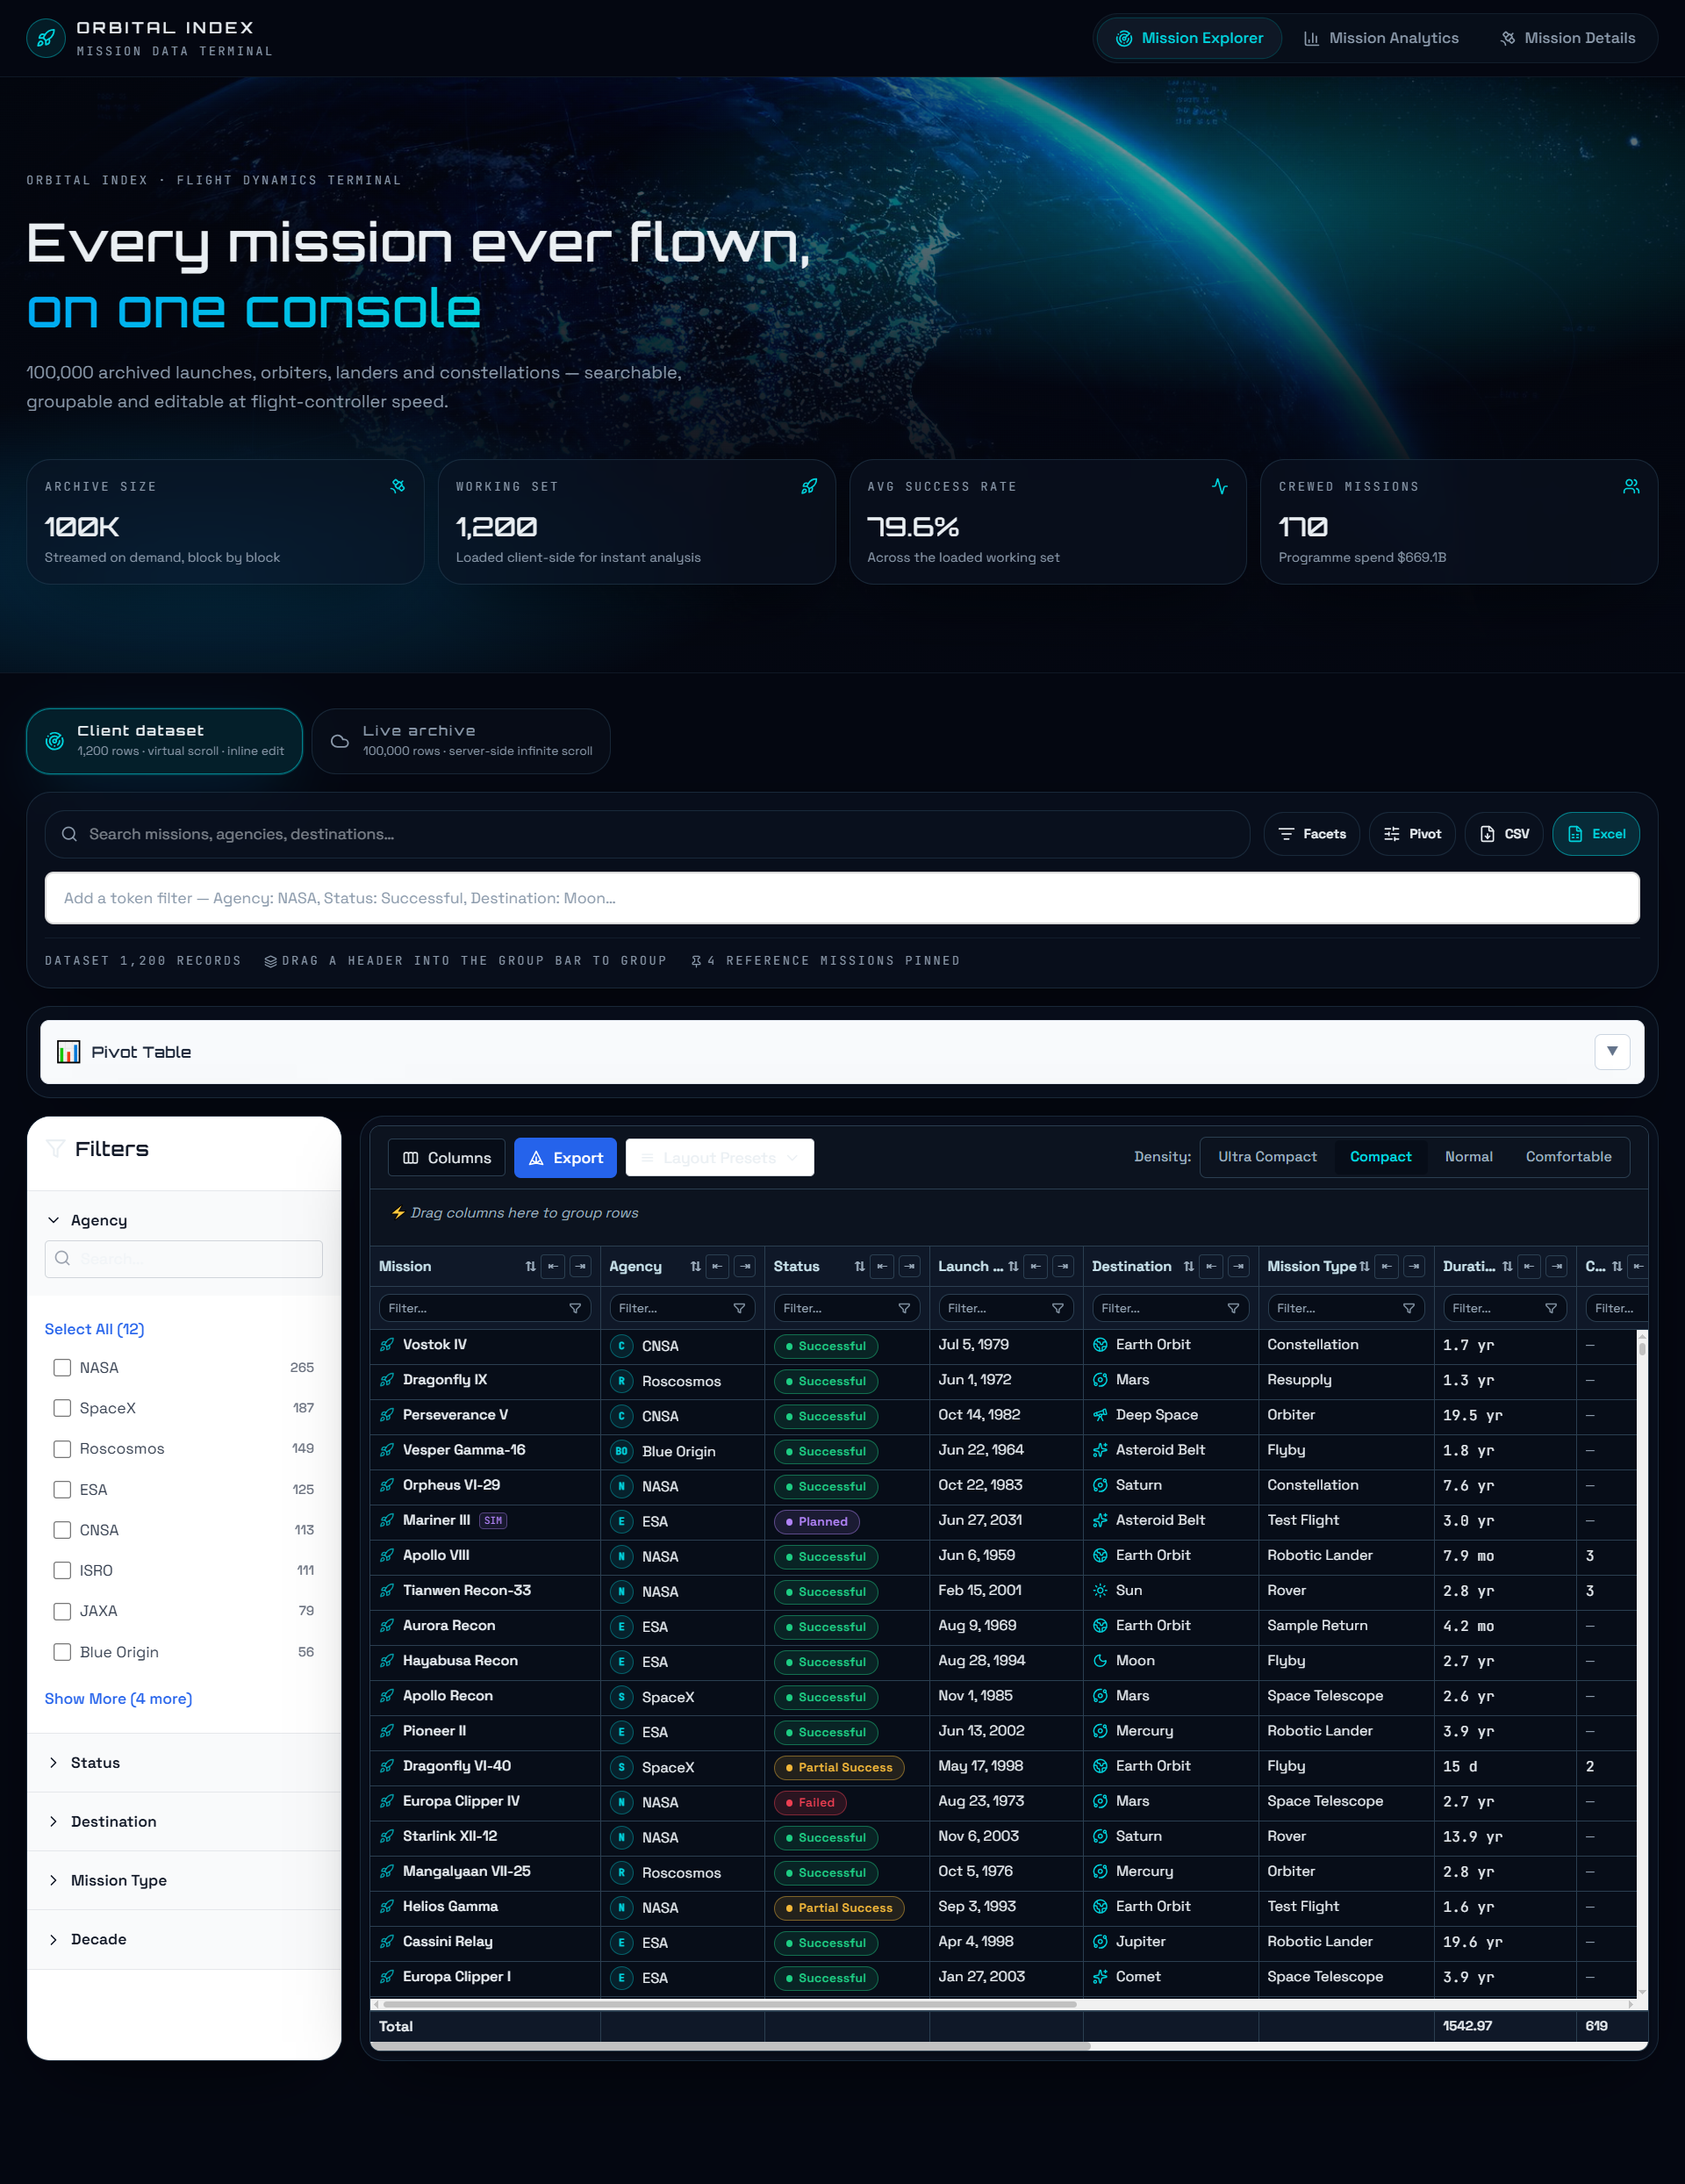 <figcaption>미션 탐사기 페이지</figcaption>
정렬, 필터링, 검색
저는 어떤 데이터 그리드에서든 기대할 수 있는 상호작용부터 시작했습니다. 컬럼 헤더는 다중 컬럼 정렬을 포함한 정렬을 지원해서, 직접 커스텀 정렬 로직을 작성하지 않고도 기관별, 그리고 발사일별로 미션을 정렬할 수 있었습니다.
필터링의 경우, 전역 검색창과 개별 컬럼 필터가 모두 있었습니다. 전역 검색은 미션, 기관, 목적지를 빠르게 찾는 것을 쉽게 만들어 주었고, 컬럼 헤더 바로 아래의 필터는 특정 필드를 좁힐 필요가 있을 때 더 많은 제어권을 제공했죠.
사이드바 필터는 이 데이터셋에 특히 유용했습니다. 모든 것을 검색창에 직접 입력하게 하는 대신, 패싯 검색(faceted search) 패널을 통해 기관, 상태, 목적지, 미션 유형, 연대별로 필터링할 수 있었거든요. 각 패싯은 NASA (265) 또는 **성공 (839)**과 같이 실시간으로 개수를 표시하여, 각 필터가 얼마나 많은 데이터를 나타내는지 즉시 확인할 수 있습니다.
만약 제가 1990년대의 화성으로 가는 NASA의 성공적인 미션만 보고 싶다면, 그리드 주위에 복잡한 필터 UI를 직접 구축할 필요 없이 여러 다른 차원에서 데이터셋을 좁힐 수 있었습니다.
또한 컬럼 크기 조절 및 재정렬도 테스트했는데, 탐사기를 다양한 화면 크기와 워크플로우에 맞출 때 둘 다 사용하기 쉬웠습니다.
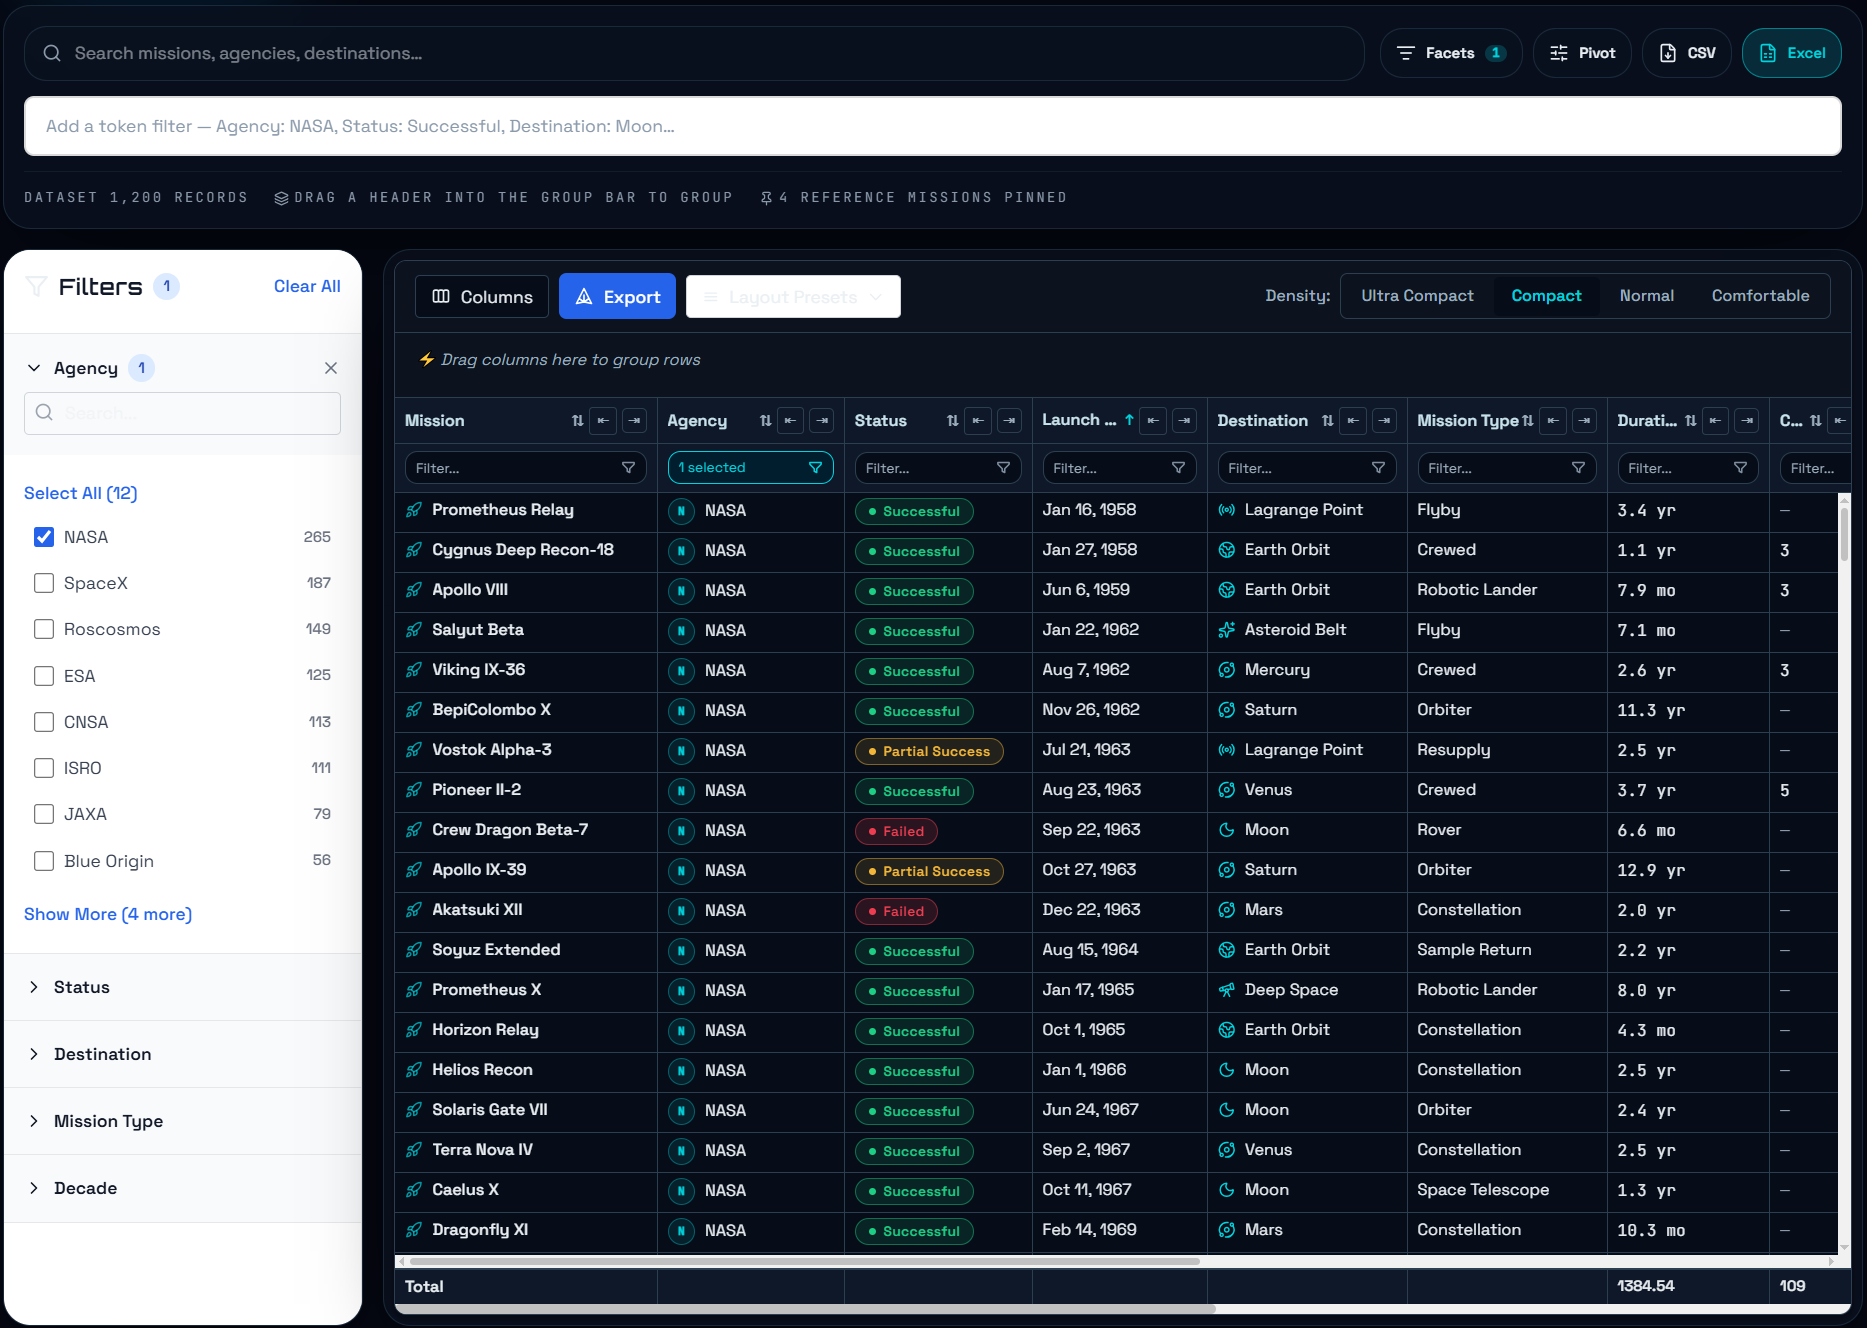 <figcaption>정렬, 필터링 및 검색</figcaption>
그룹화 및 고정
필터링이 작동하자, 그리드가 보다 분석적인 상호작용을 어떻게 처리하는지 확인하고 싶었습니다.
React DataGrid를 사용하면 컬럼을 테이블 상단의 그룹화 영역으로 드래그할 수 있습니다. 이는 모든 미션을 독립적인 행으로 취급하는 대신, 미션을 "기관"과 같은 기준으로 그룹화한 다음 다른 필드로 추가 정렬할 수 있다는 의미입니다.
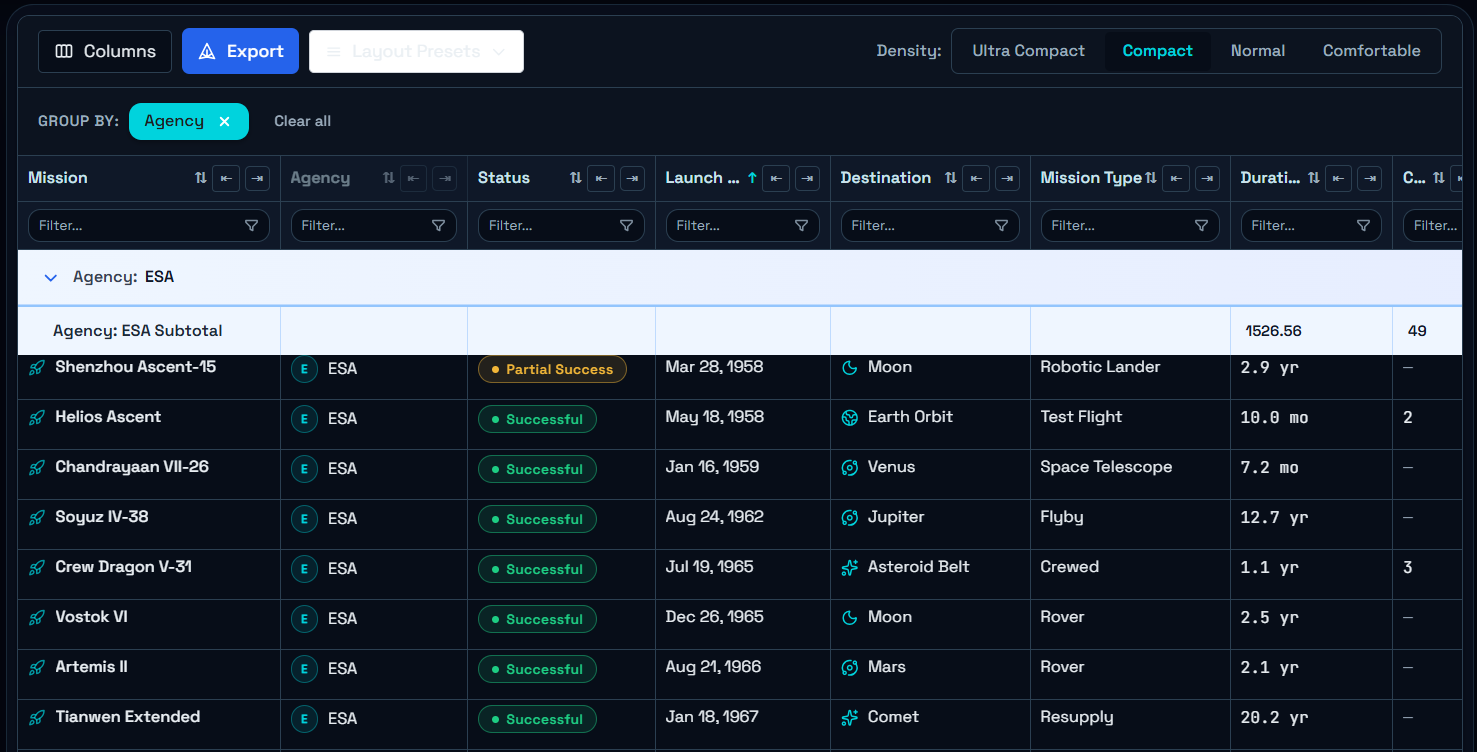 <figcaption>그룹화 및 고정</figcaption>
또한, 네 개의 참조 미션을 그리드 상단에 고정했습니다. 이는 작은 기능이지만, 대규모 데이터셋을 다룰 때 정말 유용하다는 것을 알게 되었습니다. 중요한 레코드가 고정되어 스크롤을 통해 나머지 아카이브를 탐색하는 동안에도 계속 볼 수 있기 때문이죠.
피벗 테이블
탐사기에서 가장 흥미로운 부분은 내장된 피벗 테이블(Pivot Table) 빌더였습니다.
수행하고자 하는 모든 분석에 대해 수동으로 집계 로직을 작성하는 대신, 행 그룹 기준(Row Group By), 피벗 컬럼(Pivot Column), 값 컬럼(Value Column), 그리고 **집계(Aggregation)**를 선택한 다음, 이 구성을 인터페이스에서 직접 적용할 수 있었습니다. 또한 총계 행과 총합 컬럼을 토글할 수도 있었죠.
예를 들어, 미션을 기관별로 그룹화하고, 목적지별로 피벗한 다음, 기간이나 비용과 같은 값을 집계할 수 있었습니다. 이는 그리드를 단순히 레코드를 탐색하는 공간에서 데이터셋을 탐험하는 도구로 변화시켰습니다. 제가 실무에서 대용량 데이터를 다뤄봤을 때, 단순히 검색 필드를 늘리는 것보다 이런 패싯 검색이나 피벗 테이블 빌더가 사용자 경험을 훨씬 직관적으로 개선해 준다는 걸 깨달았습니다. 개발자 입장에서도 훨씬 효율적이고요.
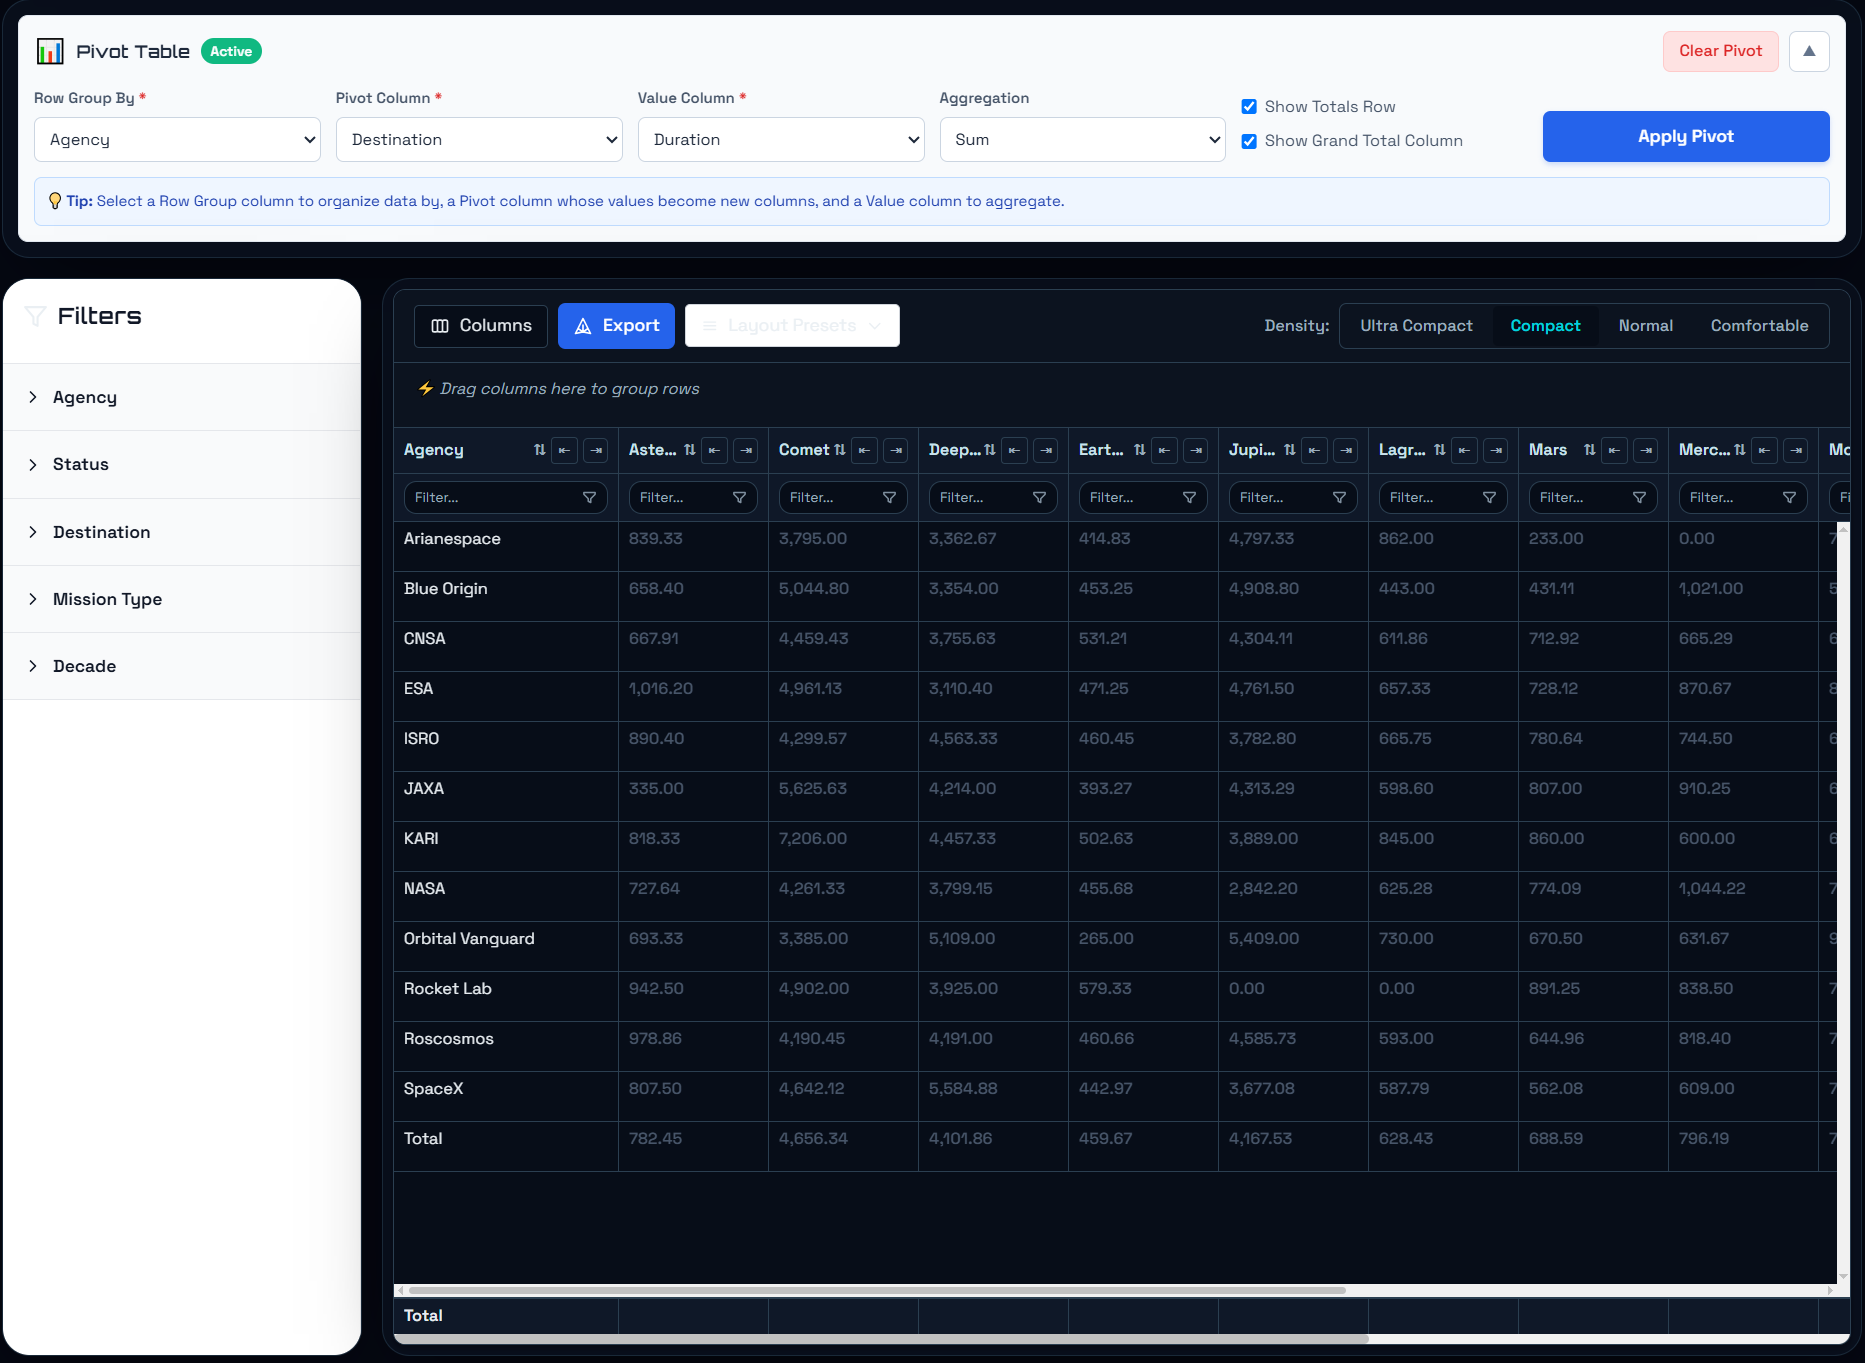 <figcaption>피벗 테이블</figcaption>
커스텀 셀, 총계, 그리고 내보내기
그리드를 더 쉽게 스캔할 수 있도록 커스텀 셀 렌더링도 사용했습니다. 미션 상태는 일반 텍스트로 표시되지 않고, 성공(Successful), 계획됨(Planned), 부분 성공(Partial Success), 실패(Failed), 취소됨(Cancelled), 진행 중(in progress) 등 색상 코드가 적용된 배지로 표현됩니다. 작업 세트에는 기간 및 비용과 같은 값을 집계하는 총계 푸터도 포함되어 있습니다.
그리드 주변에는 실제 프로덕션 데이터 테이블에서 사용할 것으로 예상되는 컨트롤들을 추가했습니다: 컬럼 선택기, CSV 및 Excel 내보내기, 레이아웃 초기화 컨트롤, 그리고 **울트라 컴팩트(Ultra Compact)**부터 **편안함(Comfortable)**까지 네 가지 밀도 옵션이죠.
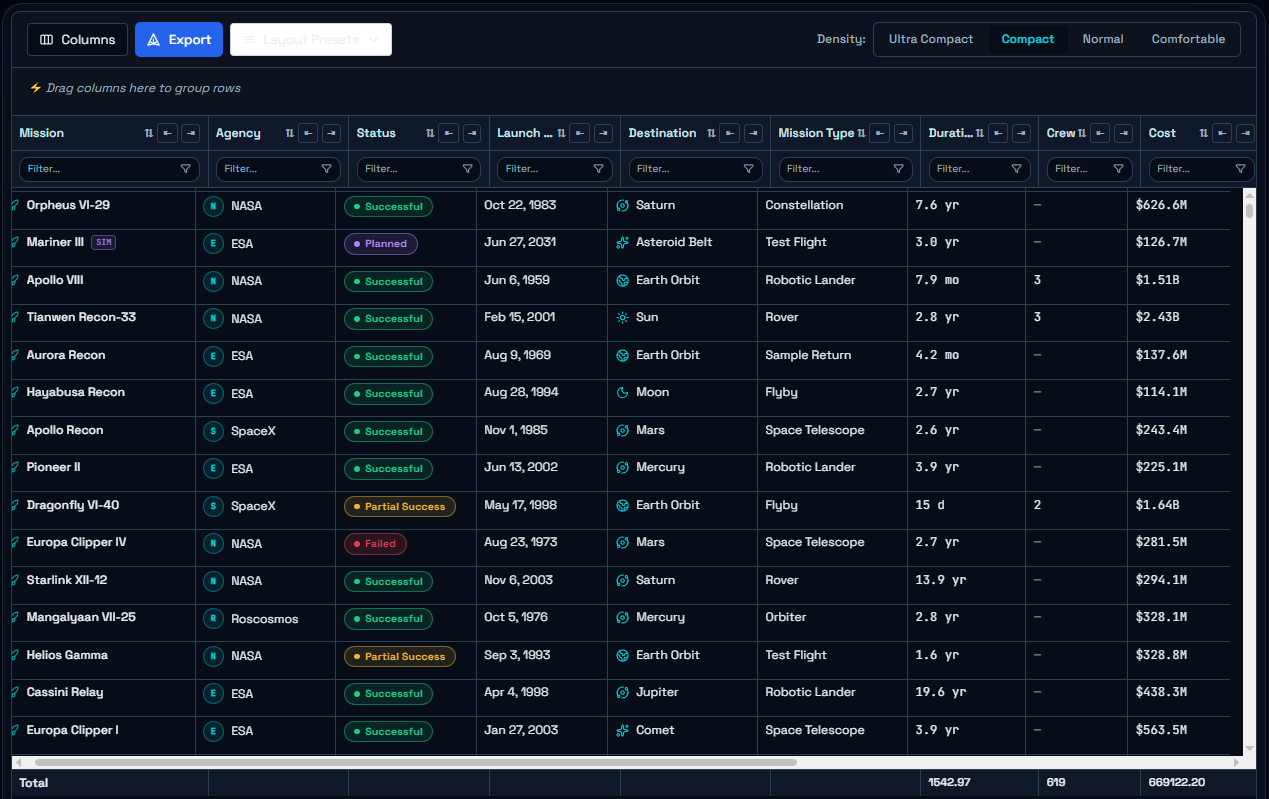 <figcaption>커스텀 셀 및 총계</figcaption>
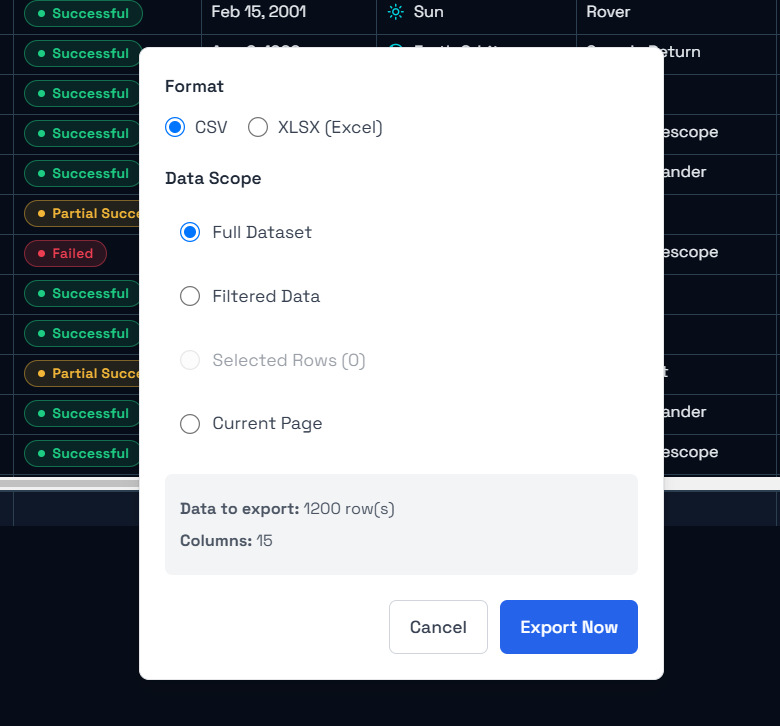 <figcaption>CSV 및 Excel 내보내기</figcaption>
가장 마음에 들었던 점은 패싯 필터링, 그룹화, 피벗팅, 고정된 행, 커스텀 렌더러, 그리고 내보내기 기능을 모두 동일한 인터페이스에서 결합할 수 있었다는 것입니다. 페이지가 서로 연결되지 않은 컨트롤들의 집합으로 변하지 않았다는 점이 특히 좋았습니다.
미션 분석 구축하기
미션 탐사기가 작동한 후, 저는 개별 레코드를 탐색하는 것을 넘어 동일한 데이터셋을 다른 용도로 사용하고 싶었습니다. 그래서 두 번째 페이지인 **미션 분석(Mission Analytics)**을 만들었죠.
이 페이지는 의도적으로 차트 중심입니다. 다른 테이블을 표시하는 대신, 탐사기에서 사용했던 것과 동일한 미션 데이터와 집계 로직을 사용하여 미션 역사, 기관, 목적지, 비용에 대한 더 높은 수준의 질문에 답하는 일련의 시각화를 생성했습니다.
상단에는 네 개의 요약 카드를 추가했습니다:
- 스코프 내 1,200개 미션
- 평균 성공률 79.6%
- 프로그램 비용 $669.12B
- 평균 미션 기간 1,543일
이 카드들 아래에는 연대별 발사 주기, 기관 신뢰도, 목적지 분포, 미션 유형별 성공 프로필, 비용 대 미션 기간이라는 다섯 가지 다른 시각화가 포함되어 있습니다.
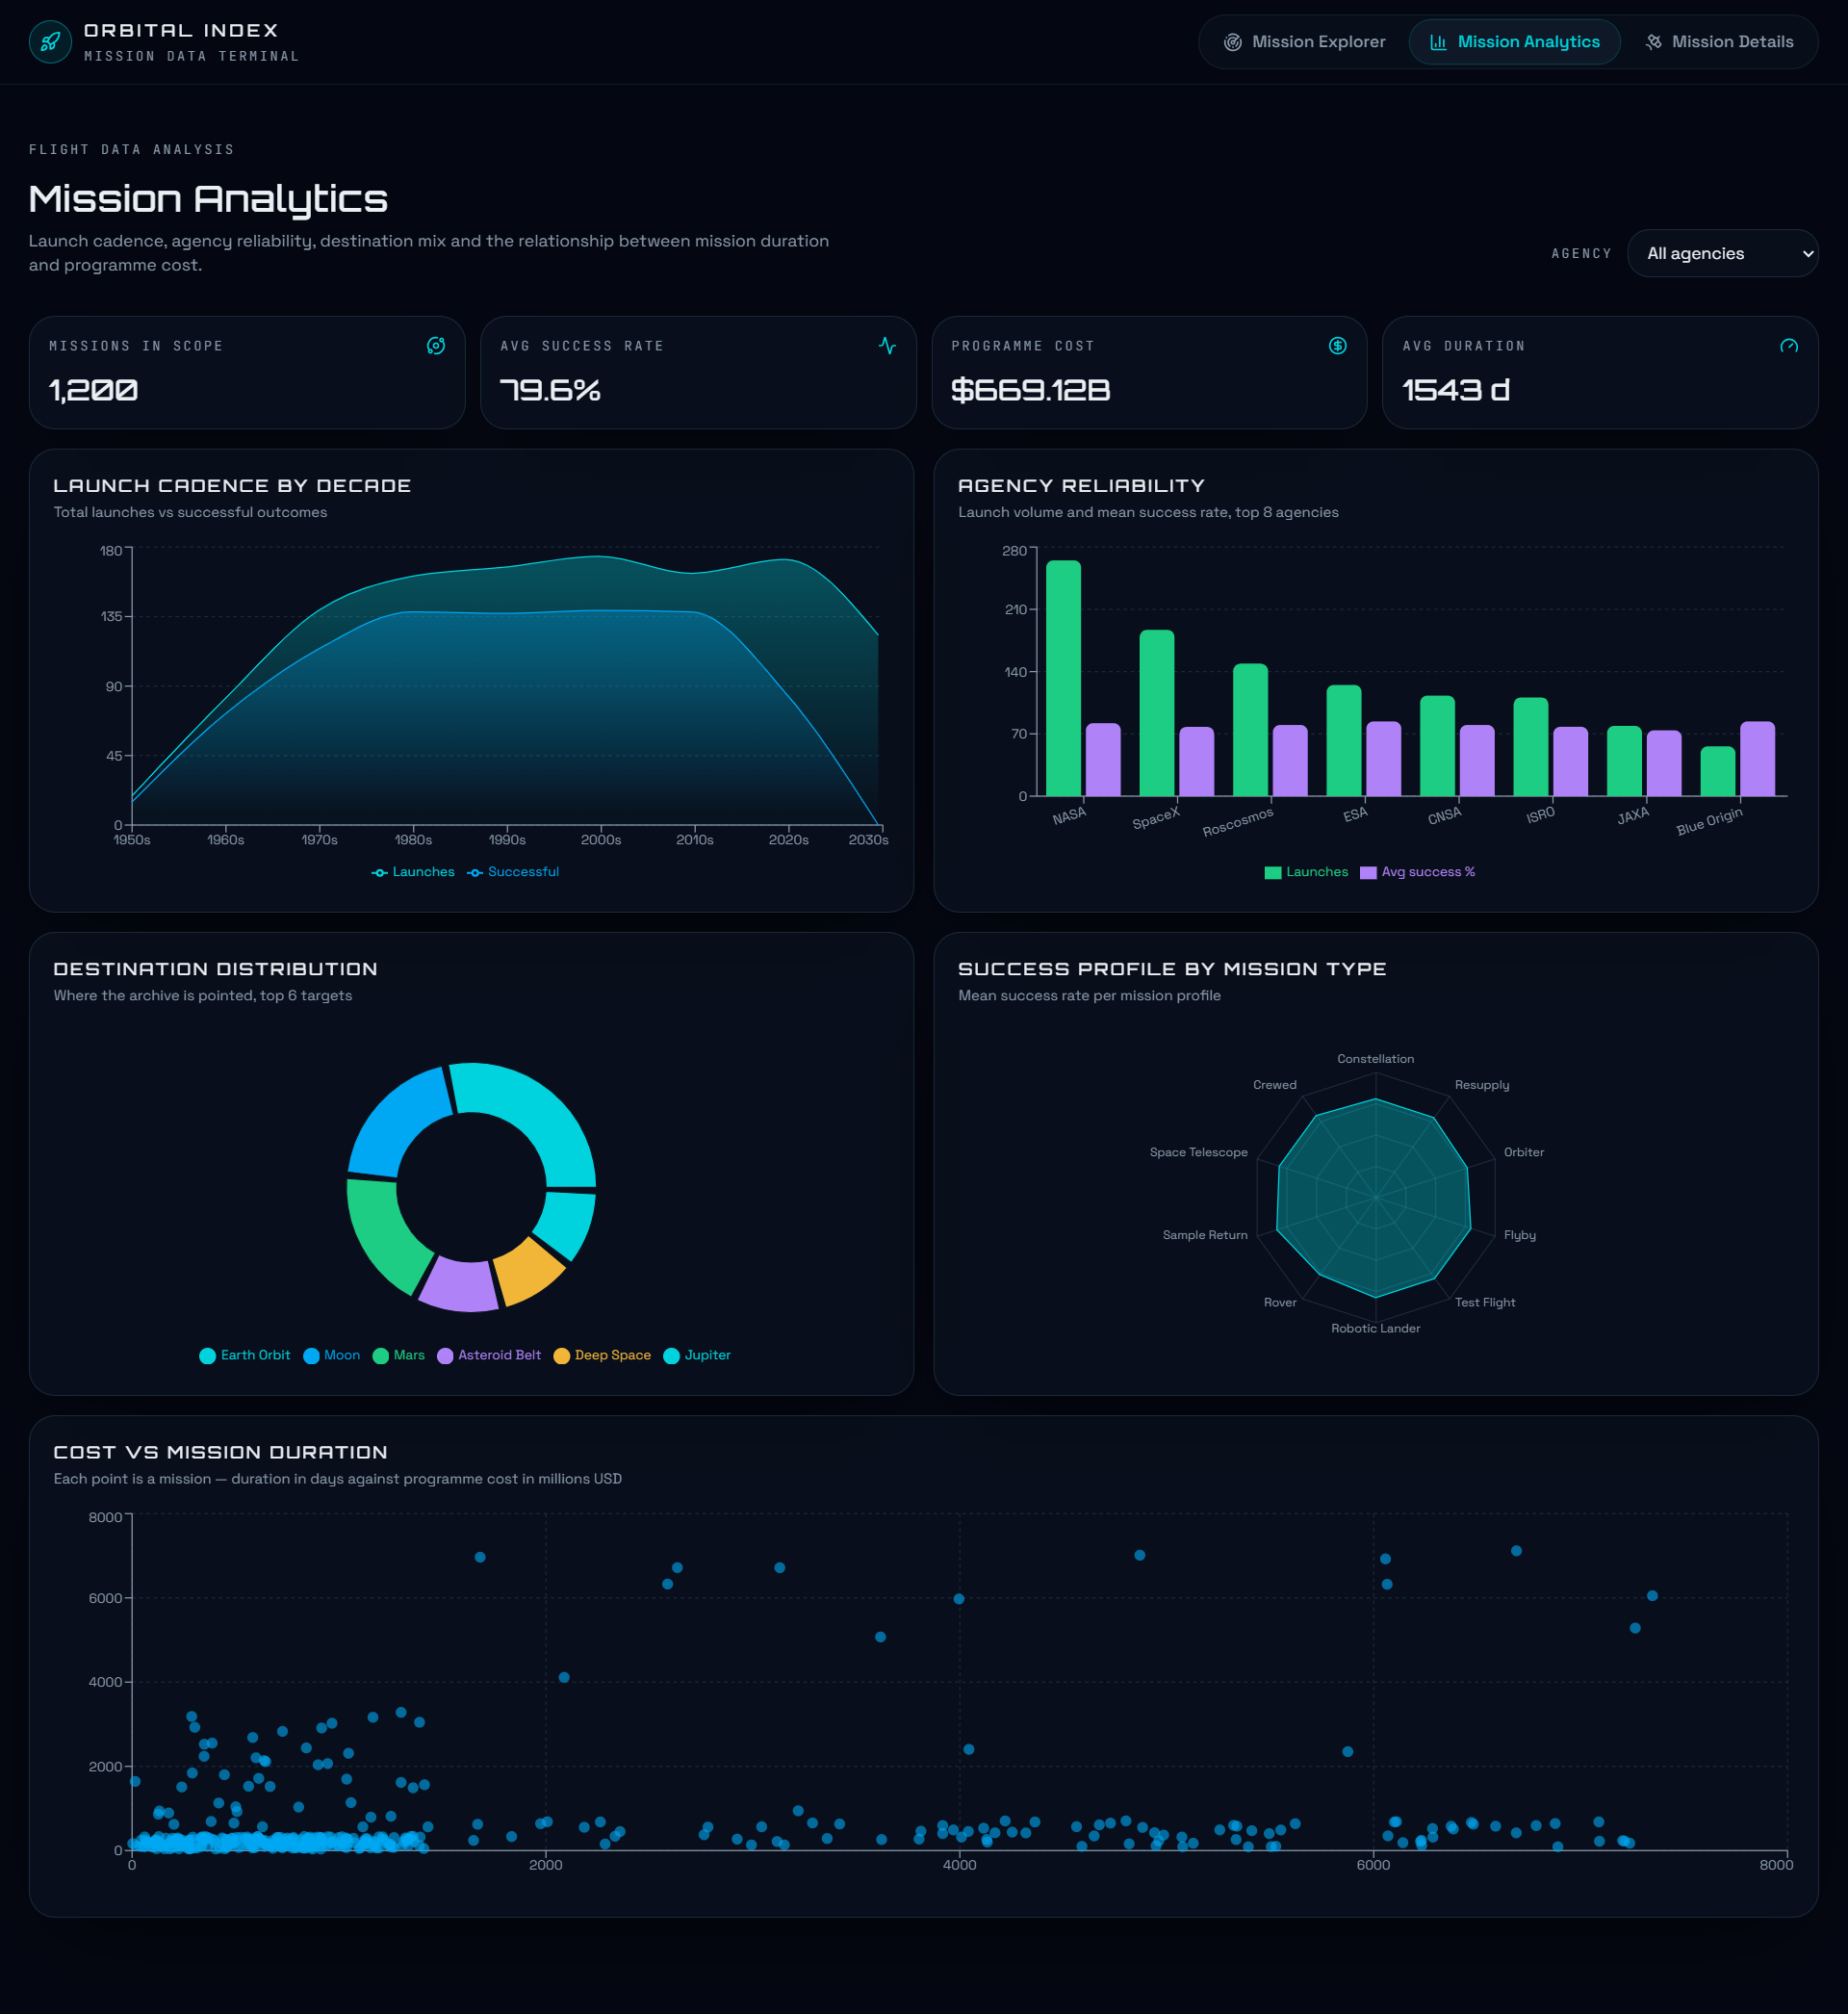 <figcaption>미션 분석 페이지</figcaption>
발사 주기 및 기관 신뢰도
첫 번째 차트는 **연대별 발사 주기(Launch Cadence by Decade)**를 보여주며, 데이터셋 내 다양한 연대에 걸쳐 미션 수와 성공적인 미션 수가 어떻게 변했는지 나타냅니다.
이는 탐사기에서 개별 행을 볼 때는 명확하지 않던 아카이브에 역사적 차원을 부여합니다. 어떤 미션이 발사되었는지 묻는 대신, 미션 활동이 시간 경과에 따라 어떻게 변했는지 묻기 시작할 수 있죠.
다음으로, 기관 신뢰도(Agency Reliability) 차트는 NASA, SpaceX, Roscosmos, ESA, CNSA, ISRO, JAXA, Blue Origin과 같은 기관들의 발사량과 평균 성공률을 비교합니다.
여기서 집계 기능이 유용하게 사용되었습니다. 이 차트는 대시보드를 위해 특별히 생성된 별도의 데이터셋을 기반으로 하는 것이 아닙니다. 탐사기에서 이미 필터링, 그룹화, 분석하고 있던 동일한 미션 기록에서 파생된 것이죠. 솔직히 이 부분은 React DataGrid의 직접적인 UI는 아니지만, DataGrid가 제공하는 데이터 처리 로직을 기반으로 시각화를 만들 수 있다는 점에서 연관성이 깊습니다. 데이터를 다양한 각도로 해석하는 능력을 보여주는 셈이죠.
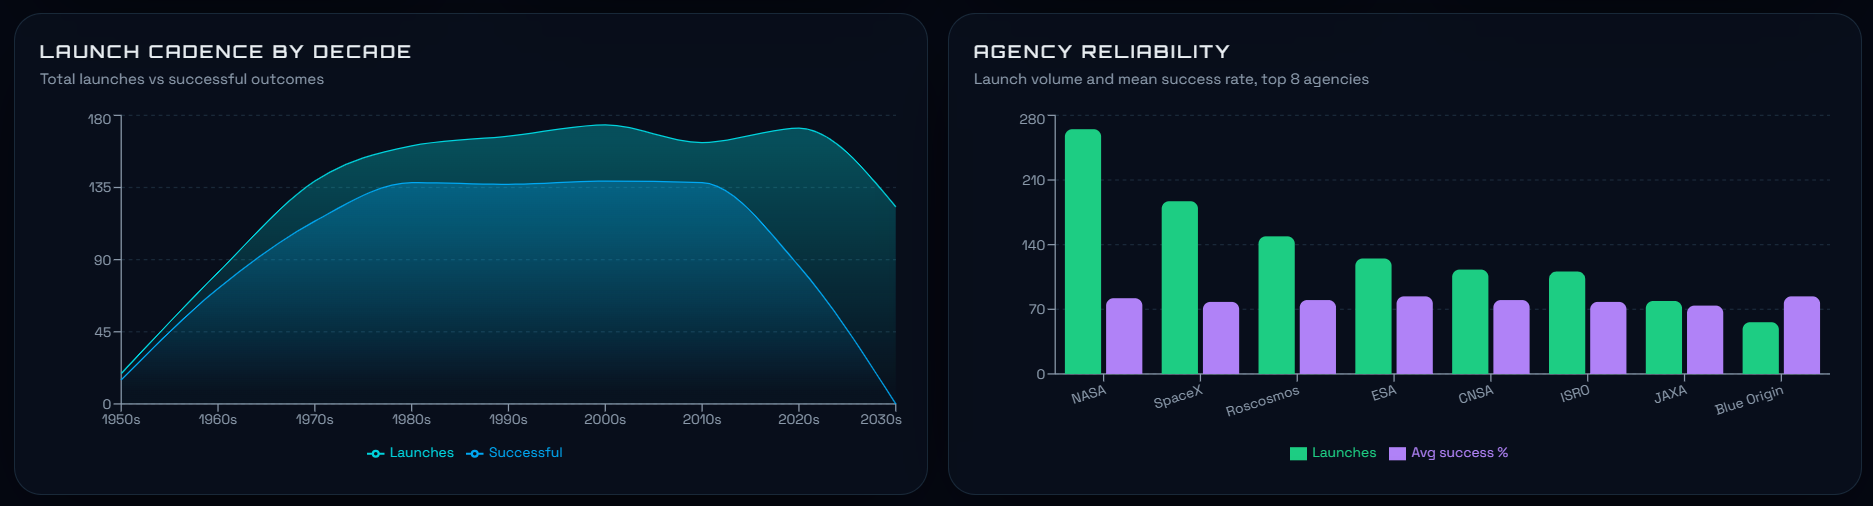 <figcaption>발사 주기 및 기관 신뢰도</figcaption>
목적지, 미션 유형 및 비용
나머지 세 가지 시각화는 동일한 데이터의 다른 차원을 살펴봅니다.
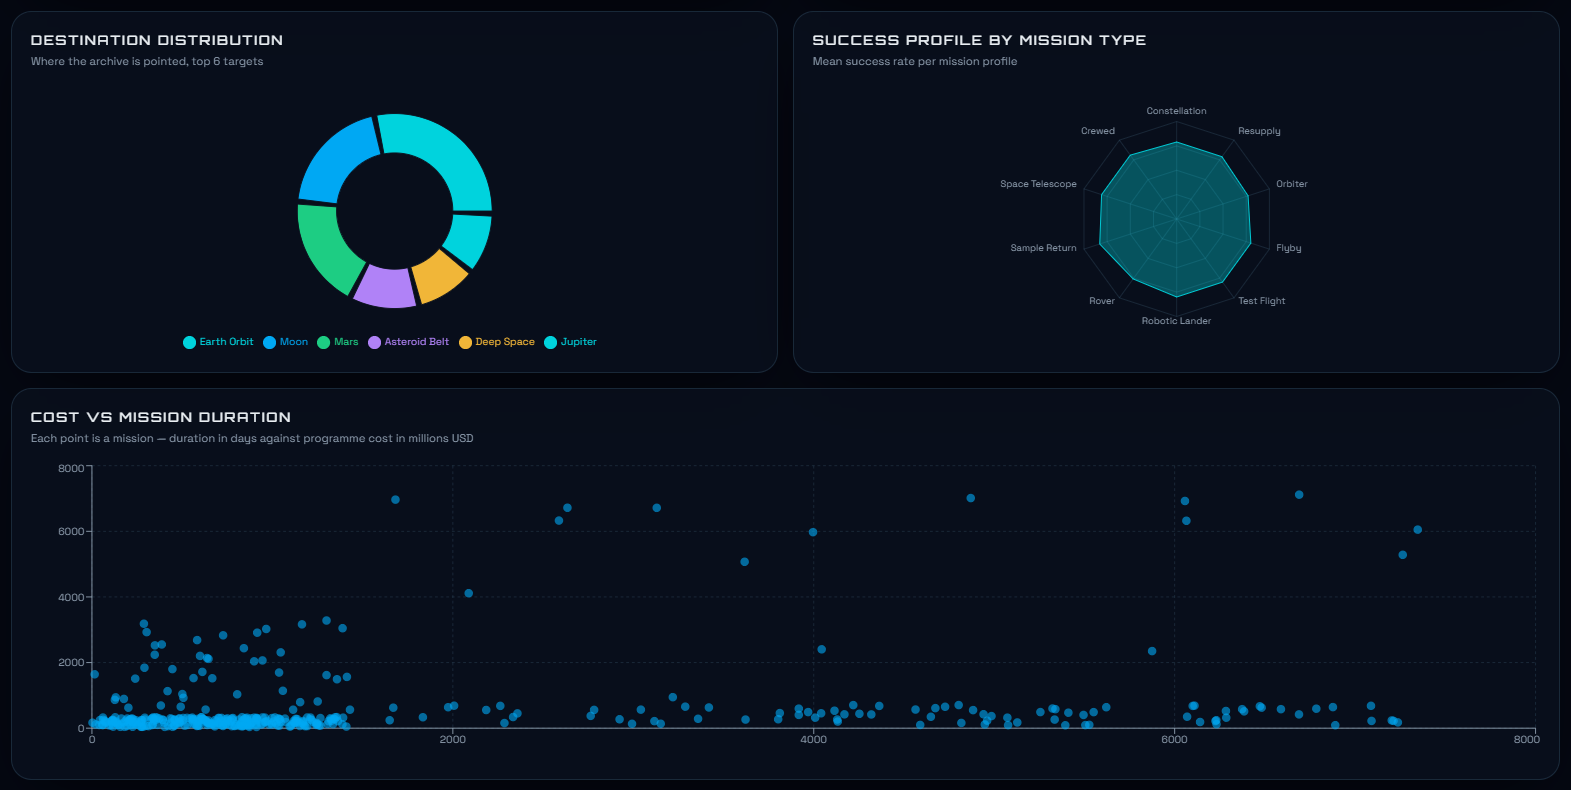
목적지 분포(Destination Distribution) 차트는 아카이브의 미션들이 어디로 향하는지 보여주며, 지구 궤도, 달, 화성, 소행성대, 심우주, 목성 등의 목적지를 포함합니다.
**미션 유형별 성공 프로필(Success Profile by Mission Type)**은 로버, 궤도선, 플라이바이, 로봇 착륙선, 우주 망원경, 샘플 회수 미션 등 미션 유형별 성공률을 비교하여 또 다른 관점을 제공합니다.
마지막으로, 비용 대 미션 기간(Cost vs. Mission Duration) 산점도는 비싼 미션이 더 긴 기간을 가지는 경향이 있는지 확인할 수 있게 해줍니다. 각 점은 개별 미션을 나타내어, 비정상적으로 비싸거나 오래 지속되는 프로그램을 쉽게 발견할 수 있도록 돕습니다.
여기서 흥미로웠던 점은 React DataGrid가 계속 유용하려면 이 페이지에 또 다른 그리드를 배치할 필요가 없었다는 것입니다. 그리드의 기본 데이터셋과 집계 로직은 여전히 작동하고 있었고, 저는 단순히 결과를 시각적으로 해석하기 쉬운 형태로 제시했을 뿐입니다.
 <figcaption>목적지, 미션 유형 및 비용</figcaption>
미션 상세 페이지 구축하기
전체 아카이브를 다룬 후, 세 번째 페이지는 그 반대의 작업을 수행하고 싶었습니다. 즉, 10만 개의 미션에서 단 하나의 특정 미션으로 드릴다운하는 것이죠.
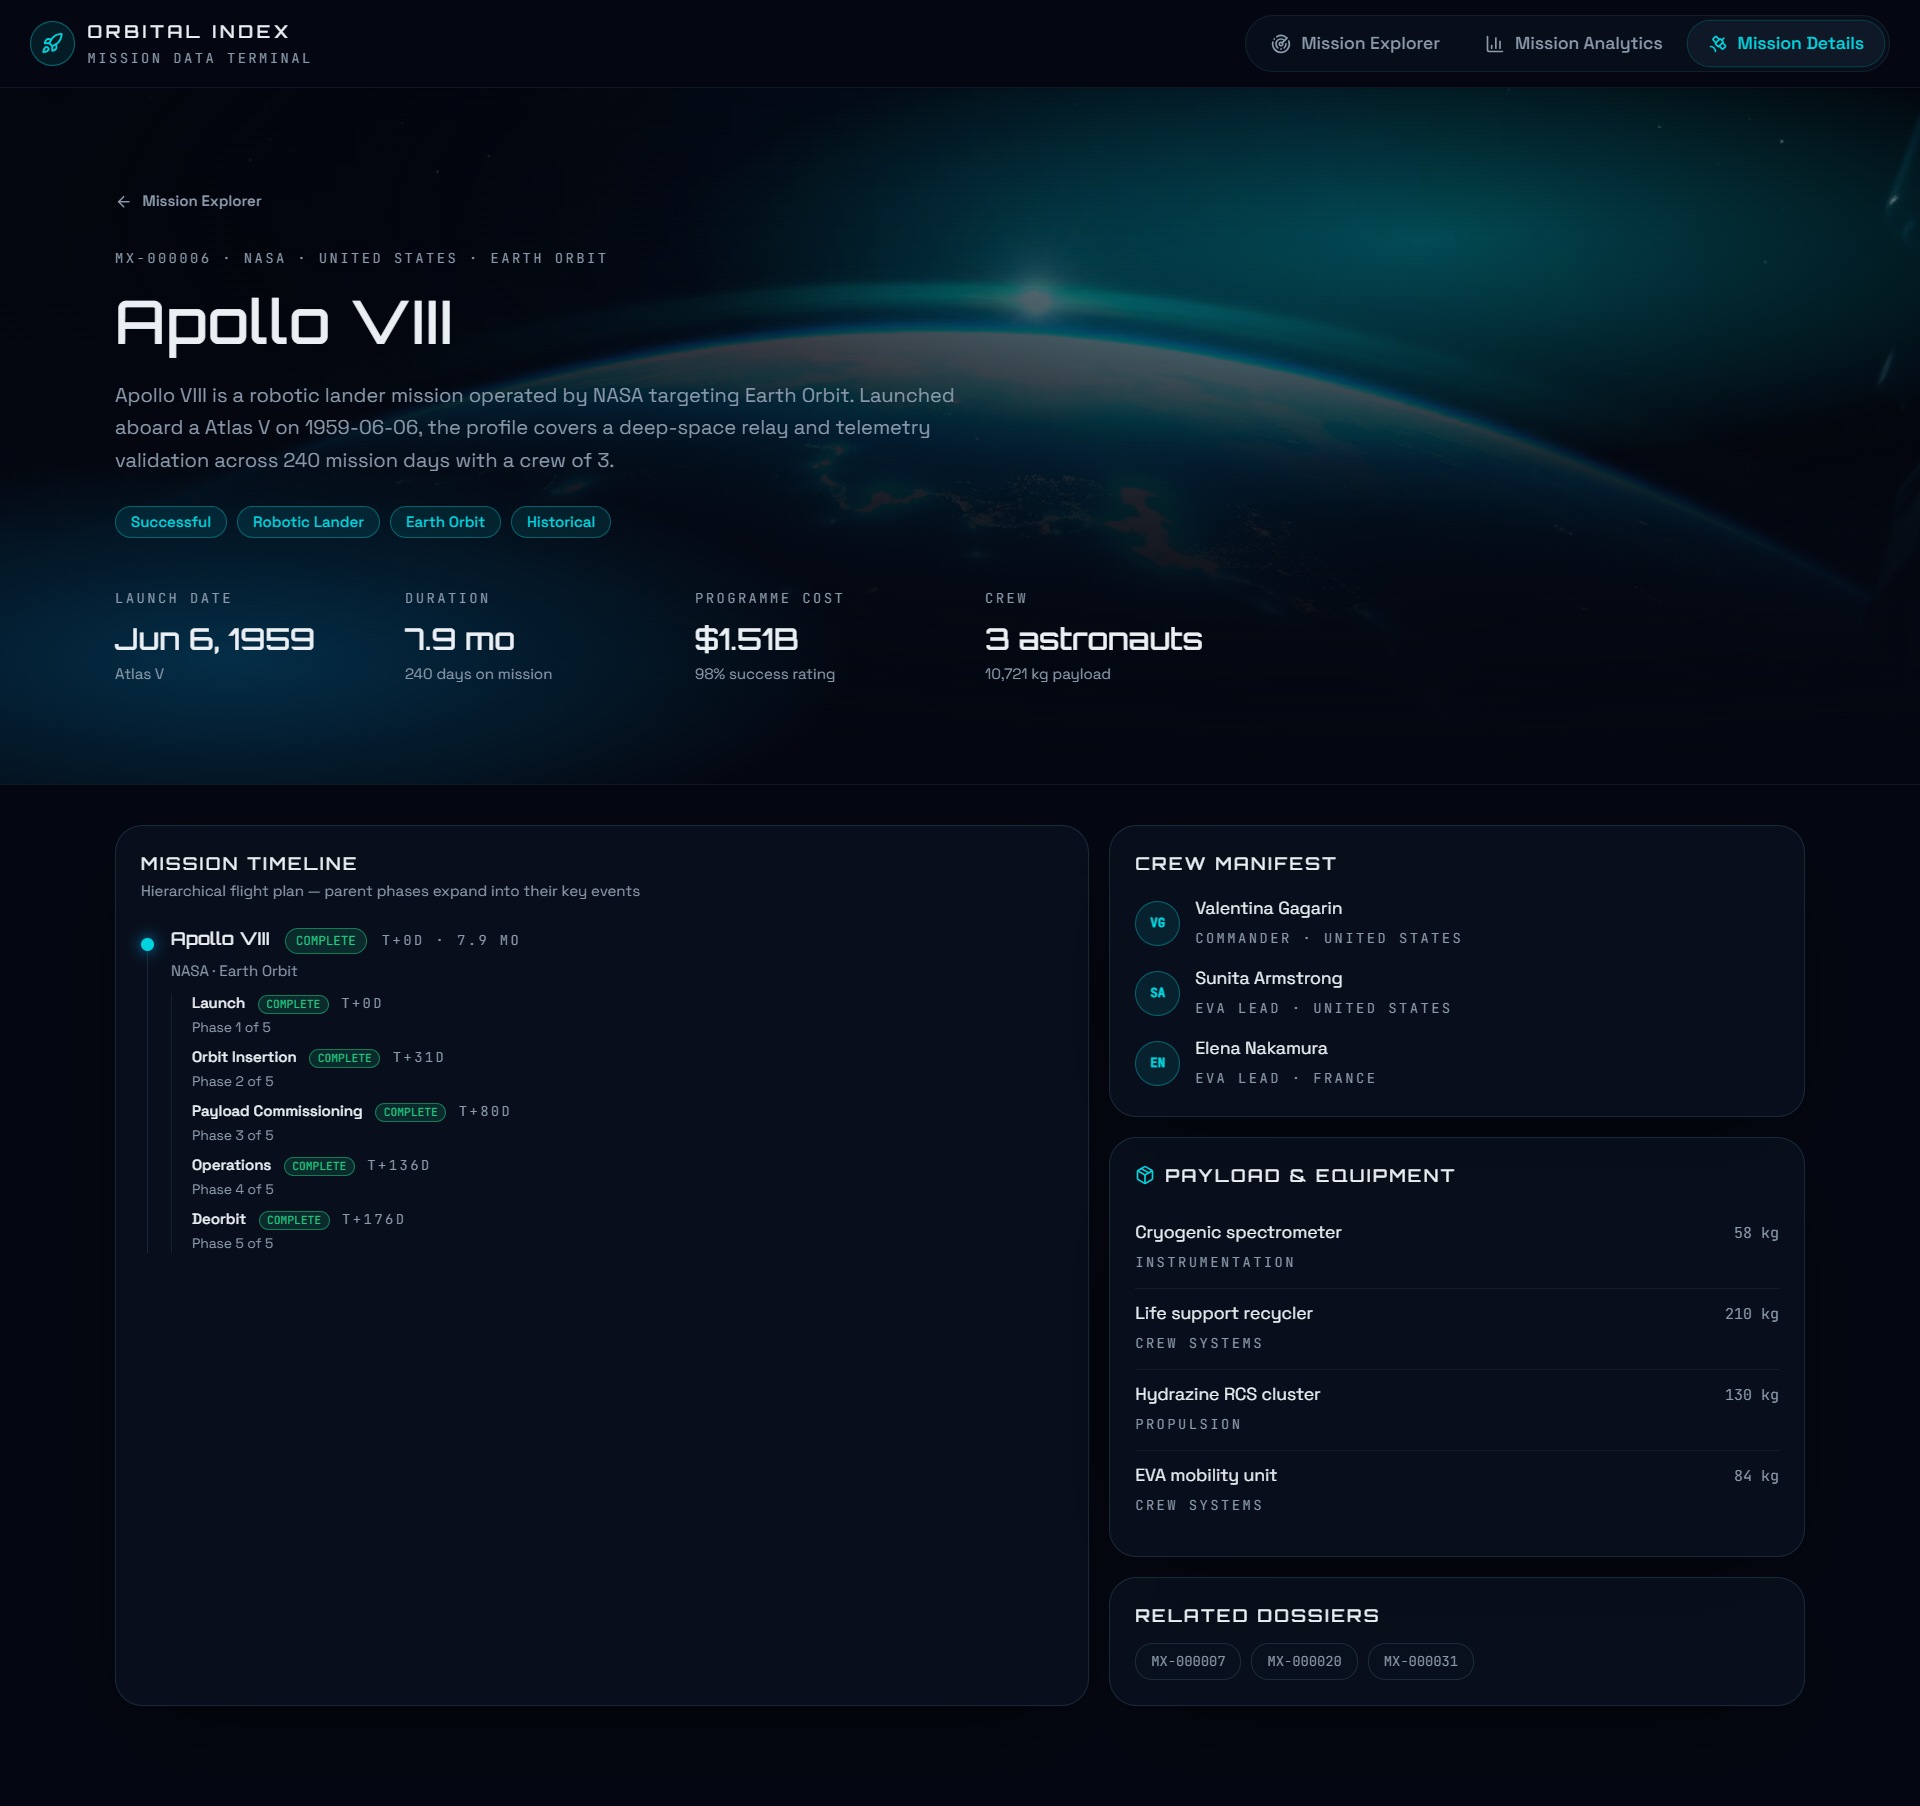
이 예시에서는 MX-000006, 아폴로 VIII를 사용했습니다. 이 페이지는 발사일, 기간, 프로그램 비용, 승무원 등 미션의 주요 정보를 모두 다른 대형 테이블에 강제로 넣지 않고 한곳에 모아 보여줍니다.
 <figcaption>미션 상세 페이지</figcaption>
하지만 이 페이지에서 가장 흥미로운 부분은 바로 **미션 타임라인(Mission Timeline)**입니다.
실제 미션 타임라인에 트리 데이터 사용하기
미션은 단순히 관련 없는 필드들의 집합이 아닙니다. 발사가 궤도 진입보다 먼저 일어나고, 궤도 진입이 미션의 주요 작전보다 먼저 일어나는 등 자연스러운 순서 구조를 가집니다.
그래서 타임라인은 **트리 데이터(Tree Data)**를 사용하기에 좋은 곳이었습니다.
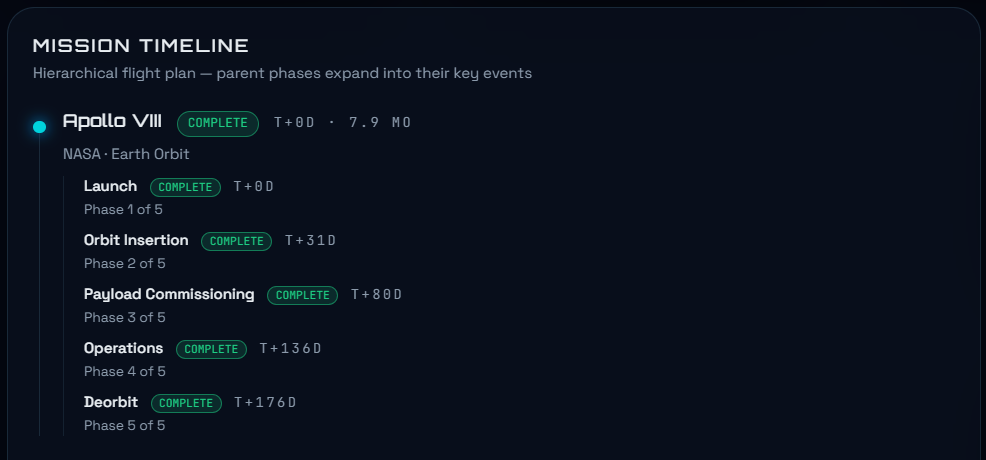
아폴로 VIII의 경우, 미션을 5단계로 구성했습니다:
아폴로 VIII
├── 발사
├── 궤도 진입
├── 페이로드 시운전
├── 작전
└── 궤도 이탈
각 단계는 자체적인 완료(COMPLETE) 상태 배지와 T+ 일 오프셋을 가지므로, 타임라인은 미션의 계층 구조와 시간적 맥락을 모두 제공합니다.
 <figcaption>실제 미션에 적용된 트리 데이터</figcaption>
이것은 실제 애플리케이션을 구축한 후에야 더 의미가 있었던 기능 중 하나입니다. 타임라인을 위해 커스텀 중첩 컴포넌트를 만들 수도 있었겠지만, 트리 데이터는 이러한 종류의 구조화된 정보에 자연스럽게 매핑됩니다. 이 트랜잭션의 타임라인을 구현하면서 Tree Data를 써보니, 복잡한 커스텀 컴포넌트를 만드는 대신 자연스러운 계층 구조를 쉽게 표현할 수 있어 개발 시간을 크게 단축할 수 있었습니다.
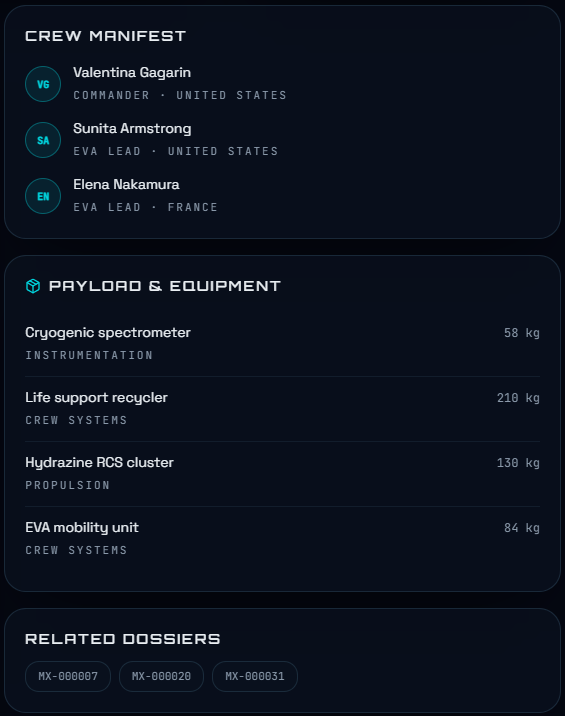
페이지의 나머지 부분에는 승무원 명단(Crew Manifest), 페이로드 및 장비(Payload & Equipment), 관련 문서(Related Dossiers) 섹션이 포함되어 있습니다. 이들은 추가 미션 정보를 접근하기 쉽게 유지하면서도 페이지를 또 다른 밀도 높은 데이터 관리 화면으로 변모시키지 않습니다.
 <figcaption>승무원 명단, 페이로드 및 장비 및 관련 문서</figcaption>
이 시점에서 애플리케이션의 세 가지 모든 부분이 함께 작동했습니다:
- 아카이브 검색 및 조작을 위한 미션 탐사기
- 더 높은 수준에서 데이터를 이해하기 위한 미션 분석
- 개별 미션으로 드릴다운하기 위한 미션 상세
이는 작은 데모 테이블보다 React DataGrid를 평가하기에 훨씬 더 좋은 환경을 제공했습니다. 실제 필터링, 그룹화, 피벗팅, 계층적 데이터, 커스텀 렌더링, 대규모 데이터셋이 모두 동일한 프로젝트에서 작동했으니까요.
테마 및 UI 커스터마이징
기능이 작동하자, 그리드가 애플리케이션 내부에 자연스럽게 어울리도록 만드는 데 시간을 할애했습니다. 기본 데이터 그리드의 모습도 작동은 했겠지만, 제가 목표로 했던 어두운 색상에 시안색 액센트가 들어간 비행 역학 터미널 스타일과는 잘 맞지 않았죠.
그리드의 외관을 조정하기 위해 테마 변수를 사용했고, 미션 상태 배지를 위해 커스텀 셀 렌더러를 추가했습니다. 이 배지들은 성공, 계획됨, 부분 성공, 실패, 취소됨, 진행 중과 같은 상태에 대해 다른 색상을 사용하여 탐사기 화면을 훨씬 쉽게 스캔할 수 있도록 만듭니다.
또한, **울트라 컴팩트(Ultra Compact), 컴팩트(Compact), 일반(Normal), 편안함(Comfortable)**의 네 가지 밀도 모드를 사용하여, 그리드 레이아웃을 다시 만들 필요 없이 행당 표시되는 정보의 양을 조정할 수 있도록 했습니다.
여기서 제가 높이 평가했던 점은 커스터마이징이 컴포넌트의 기본 스타일링과 씨름할 필요가 없었다는 것입니다. 대부분의 작업은 그리드 자체를 우회하려는 시도보다는 React DataGrid가 프로젝트의 시각적 언어와 일치하도록 만드는 것에 초점을 맞췄습니다.
개발자 경험: 쉬웠던 점과 더 많은 노력이 필요했던 점
전반적인 개발자 경험은 이 프로젝트의 가장 큰 장점 중 하나였습니다. 설치와 첫 그리드를 화면에 띄우는 데 예상보다 적은 시간이 걸렸고, API도 익숙하게 느껴졌습니다.
기본 그리드가 실행된 후에는 정렬, 필터링, 그룹화, 피벗 테이블 빌더를 추가하는 것이 간단했고, 문서화된 예제와 일치했습니다. 미션 상세 페이지의 트리 데이터 구현도 마찬가지였죠. 라이브러리가 설계되지 않은 작업을 수행하게 하려고 끊임없이 방법을 찾아 헤맬 필요가 없었습니다.
접근성 또한 그리드 작업을 하면서 신경 썼던 부분입니다. 키보드 내비게이션을 테스트하고 인터페이스를 통해 작업하면서 그리드의 ARIA 동작에도 주의를 기울였습니다. 문서는 제가 사용하던 덜 일반적인 기능들을 이해하는 데 충분한 예제를 제공하기도 했습니다.
그렇다고 모든 과정이 똑같이 간단했던 것은 아닙니다. 더 전문화된 기능들은 정렬이나 필터링과 같은 일상적인 작업보다 이해하는 데 더 많은 시간이 필요했습니다. 피벗 테이블 빌더와 트리 데이터 구성은 예제를 확인하고 데이터를 정확히 어떻게 구조화할지 알아내는 데 더 많은 시간을 보냈던 영역입니다. 저도 처음에는 피벗 테이블이나 Tree Data 같은 고급 기능 설정에 시간을 좀 들였지만, 일단 개념을 잡고 나니 유연하게 활용할 수 있더군요. 문서와 예제가 큰 도움이 됐습니다.
React DataGrid vs. 기본 HTML 테이블: 무엇을 선택할 것인가
만약 제가 5~10개의 정적 데이터 행만 표시해야 했다면, React DataGrid를 사용하지 않았을 겁니다. 기본적인 HTML 테이블이나 경량 React 테이블이 더 간단하고 충분히 잘 작동했을 테니까요.
하지만 이 프로젝트는 매우 다른 상황이었습니다.
10만 개의 미션, 패싯 검색, 다중 컬럼 정렬, 그룹화, 피벗팅, 트리 데이터, 커스텀 셀 렌더러, 서버 사이드 무한 스크롤이 필요해지자, 기본적인 테이블로는 그 기능의 상당 부분을 직접 구축해야 했을 겁니다.
바로 이 지점에서 React DataGrid가 더 의미 있었습니다. 테이블 인프라를 구축하고 유지보수하는 데 시간을 보내는 대신, 실제 애플리케이션에 집중할 수 있었죠. 미션을 어떻게 구성해야 하는지, 사용자가 무엇을 탐색할 수 있어야 하는지, 그리고 분석이 어떻게 작동해야 하는지에 대해서요.
React DataGrid, 과연 사용할 가치가 있을까?
이것으로 프로젝트를 구축해 본 결과, React DataGrid는 데이터 자체가 사용자 경험의 주요 부분인 애플리케이션에 적합하다고 생각합니다.
특히 다음의 경우에 고려해 볼 만합니다:
- 데이터 집약적인 대시보드
- 분석 애플리케이션
- 관리자 인터페이스
- 금융 애플리케이션
- 내부 비즈니스 도구
- 대규모 데이터셋을 다루는 애플리케이션
- 복잡한 필터링 또는 그룹화가 필요한 프로젝트
- 계층적 데이터가 필요한 애플리케이션
- 서버 사이드 데이터 로딩이 필요한 React 애플리케이션
우주 미션 탐사기는 이러한 요구사항 중 여러 가지를 한 번에 결합했기 때문에 좋은 테스트였습니다. 인터랙티브 분석을 위한 1,200개 행의 클라이언트 측 작업 세트와 서버 사이드 무한 스크롤을 사용하는 10만 개 미션의 라이브 아카이브를 모두 다뤘으니까요.
마무리 생각
우주 미션 탐사기를 구축하면서 기능 체크리스트만으로는 얻을 수 없었던 React DataGrid에 대한 더 나은 관점을 얻을 수 있었습니다.
실제 데이터셋을 가져와 10만 개 행의 미션 아카이브를 위한 인터랙티브 탐사기로 만들고, 그 주변에 분석 기능을 구축했으며, 미션 타임라인에 트리 데이터를 사용하는 과정에서 그리드 인프라를 직접 구축할 필요가 없었습니다.
데이터가 많은 React 애플리케이션의 경우, 궁극적으로 중요한 것은 이것입니다:
<mark>그리드는 데이터의 복잡성을 처리해야 개발자가 그 위에 제품을 구축하는 데 집중할 수 있습니다.</mark>
| 읽어주셔서 감사합니다! 🙏🏻 <br/> 유용했기를 바랍니다 ✅ <br/> 더 많은 글을 위해 반응과 팔로우 부탁드립니다 😍 <br/> Hadil Ben Abdallah와 💙 함께 만들었습니다 | 

 |
|---------|----------|---------|
{% embed https://dev.to/hadil %}
원문: https://dev.to/hadil/i-used-react-datagrid-to-build-a-real-space-mission-explorer-4g8b 수집일: 2026-08-25 00:31:10